KI-Agenten für die Bearbeitung von Kundenanfragen
Wie AltaSigma Wissen aus Support-Tickets und Dokumenten für KI-Agenten erschließt – für fundierte Antwortvorschläge bei der Bearbeitung von Kundenanfragen.

In diesem Beitrag
In beantworteten Support-Tickets, Prozessdokumentationen und gemeinsam genutzten E-Mail-Postfächern steckt wertvolles Unternehmenswissen. Damit KI-Agenten dieses Wissen für fundierte Antworten nutzen können, müssen die Inhalte aufbereitet und für die gezielte Suche indiziert werden. Support-Tickets enthalten unstrukturierte Beschreibungen von Problemen und Lösungswegen sowie Angaben zu Kunden, Produkten und Vorgängen. Um sowohl die Inhalte als auch ihre Zusammenhänge zu erschließen, bietet sich eine Kombination zweier Ansätze an: Ein Knowledge Graph bildet die beteiligten Entitäten und ihre Beziehungen ab. Eine Vektordatenbank macht inhaltlich ähnliche Anfragen und dokumentierte Lösungen auffindbar. Auf dieser Grundlage können KI-Agenten Antwortvorschläge erstellen, die das Support-Team prüft, bei Bedarf anpasst und für den Versand freigibt.
Von historischen Tickets zu fundierten Antwortvorschlägen
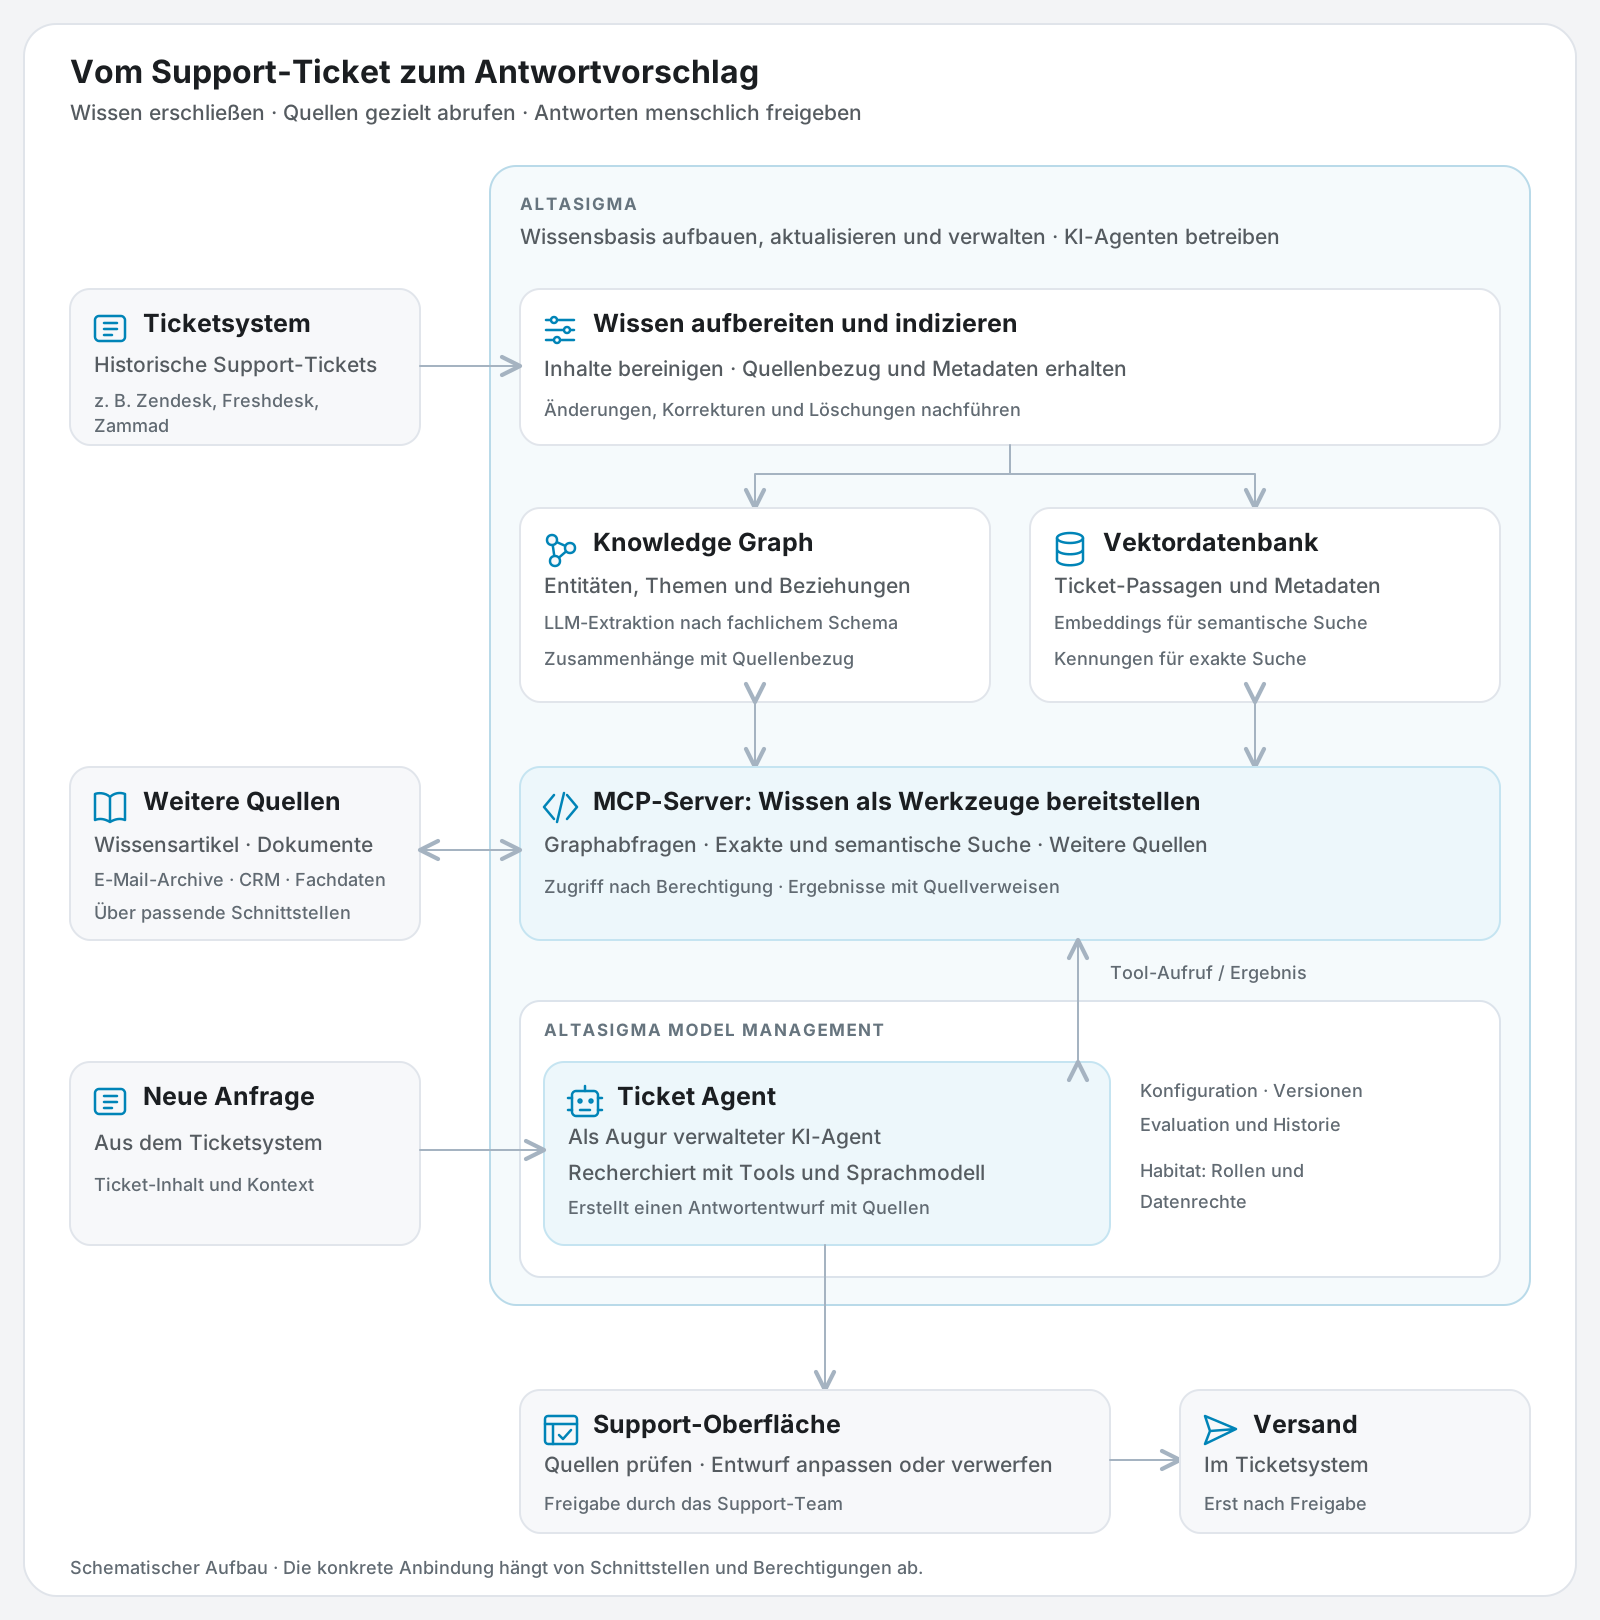
Der Ticket Agent verbindet die Recherche im Unternehmenswissen mit der Bearbeitung neuer Support-Anfragen. In AltaSigma bereiten wir historische Ticket-Informationen auf und pflegen sie in einem Knowledge Graph und einer Vektordatenbank. Über MCP-Tools greift der Agent auf unterschiedliche Sichten dieses Wissens zu. Der Graph erschließt Beziehungen zwischen Kunden, Geräten und Vorgängen. Die Suche im indizierten Ticket-Bestand liefert gezielt gesuchte Inhalte und ähnliche Fälle. Weitere Quellen lassen sich über passende Schnittstellen ergänzen.
Sobald eine neue Kundenanfrage in einem Ticketsystem wie Zendesk, Freshdesk, Jira Service Management oder Zammad eingeht, recherchiert der Ticket Agent dazu relevante Vorgänge, frühere Support-Fälle und passende Lösungswege. Auf dieser Grundlage erstellt er einen Antwortentwurf mit Verweisen auf die verwendeten Quellen. Das Support-Team kann den Vorschlag im Bearbeitungsablauf des Tickets prüfen und anpassen. Wie der Agent in das jeweilige Ticketsystem eingebunden wird, hängt von den verfügbaren Schnittstellen und Berechtigungen ab.
Der Ticket Agent ist eine im AltaSigma Model Management verwaltete AI-Anwendung – in der Plattform als Augur bezeichnet. Dort legen wir fest, welches Sprachmodell er verwendet, welche Quellen er heranzieht und welche Werkzeuge er nutzen darf.
Knowledge Graph: Zusammenhänge zwischen Tickets, Kunden und Vorgängen erschließen
Support-Tickets stehen selten für sich allein. Sie gehören zu Kunden, beziehen sich auf bestimmte Produkte oder Geräte und dokumentieren Servicevorgänge, Bestellungen oder frühere Lösungsversuche. Diese Entitäten tauchen häufig in mehreren Tickets auf. Die Informationen zu einem Vorgang können dadurch über verschiedene Anfragen und Zeitpunkte verteilt sein.
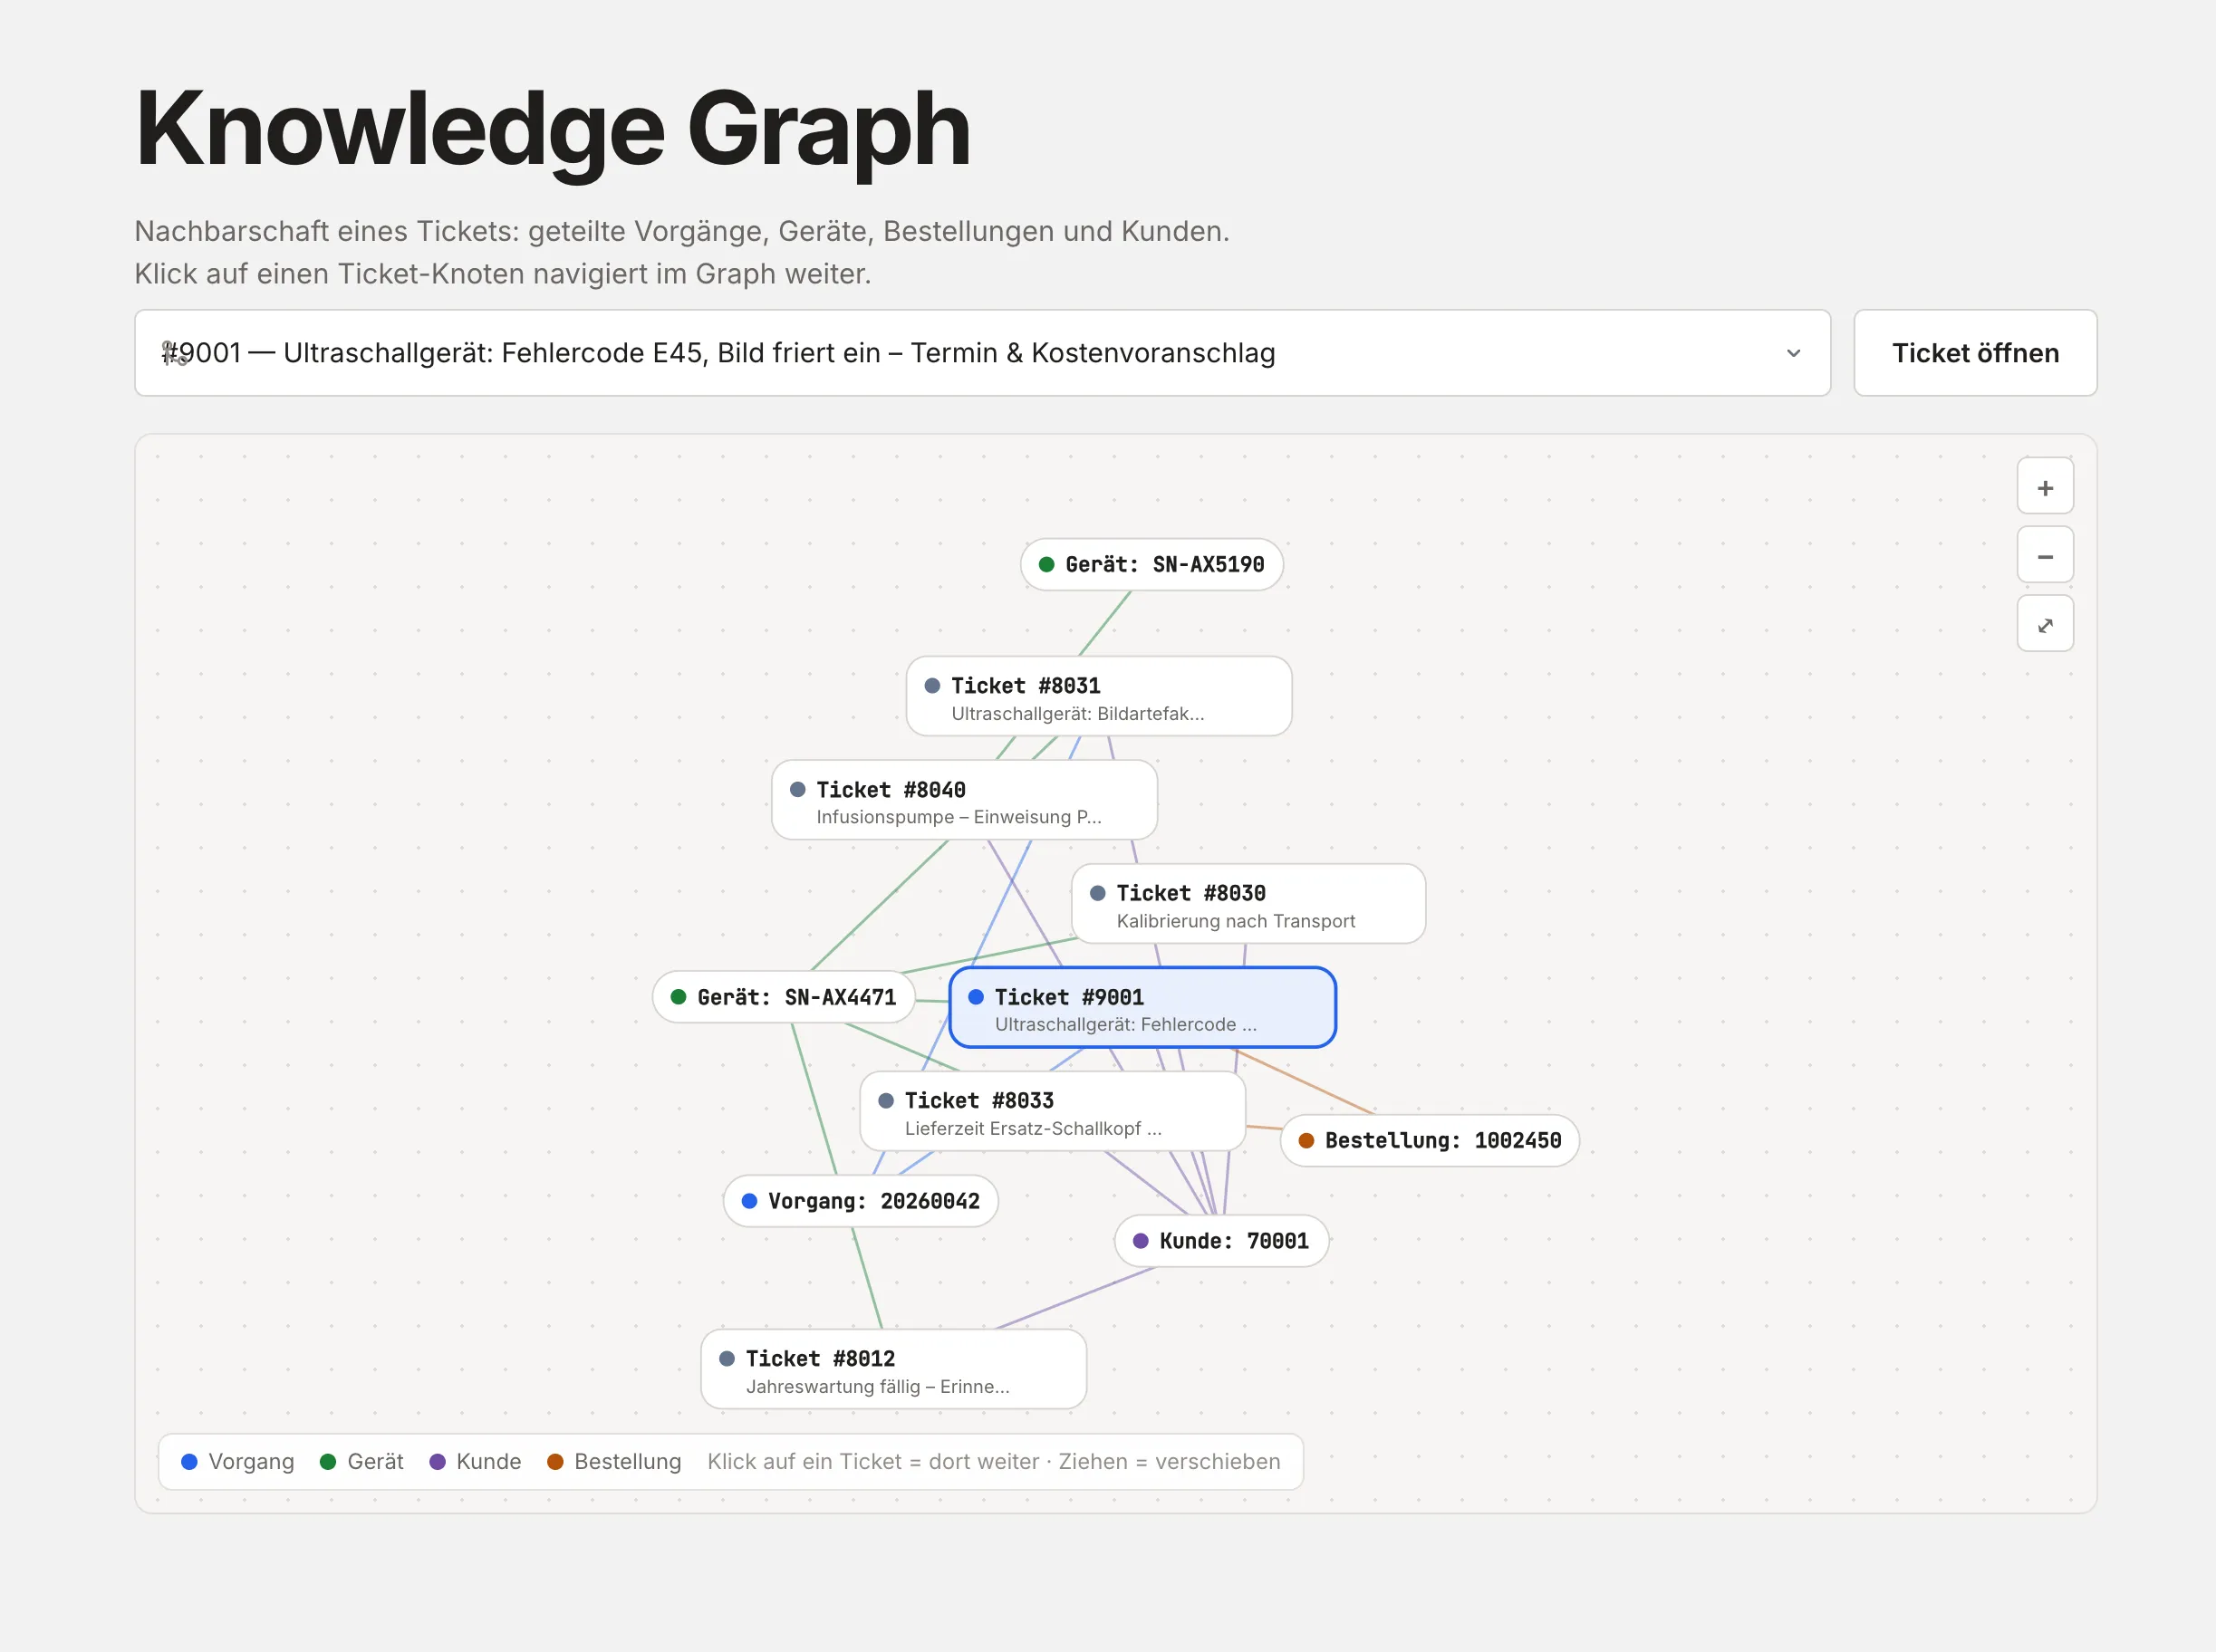
Für einen passenden Antwortvorschlag muss der Agent erkennen, welche Informationen zur aktuellen Anfrage gehören und wie sie zusammenhängen. Ein Knowledge Graph macht diese Beziehungen explizit: Aus den Ticket-Inhalten werden Kunden, Geräte, Bestellungen und weitere relevante Entitäten extrahiert und miteinander sowie mit den ursprünglichen Tickets verknüpft. So lässt sich nachvollziehen, was zu einem Gerät bereits gemeldet wurde, welche Maßnahmen erfolgt sind und welche Fragen noch offenbleiben.
Ein fiktives Beispiel verdeutlicht das: Die Muster GmbH schreibt: „Gerät A zeigt wieder einen Fehler. Können Sie uns ein Ersatzteil schicken?“ Über die Verbindung zwischen Gerät, Servicevorgang und Bestellung lässt sich ein früheres Ticket finden, in dem bereits eine Ersatzteilbestellung dokumentiert ist. Damit erhält der Agent den Kontext, um in seinem Antwortvorschlag auf die bestehende Bestellung einzugehen und zunächst deren Status zu klären.
Wie wir die Beziehungen erschließen
Für den Aufbau nutzen wir ein Sprachmodell (Large Language Model, LLM), das aus Ticket-Texten Entitäten und Beziehungen extrahiert und Themen zuordnet. Entitäten sind beispielsweise Kunden, Geräte oder Bestellungen. Vorhandene Ticket-Felder ergänzen die aus dem Text gewonnenen Angaben.
Ein gemeinsames fachliches Schema gibt vor, welche Objekte und Beziehungen relevant sind. Eine Ontologie kann dieses Begriffs- und Beziehungsmodell formal beschreiben – etwa, dass eine Bestellung zu einem Servicevorgang gehört. Für den Einstieg kann ein schlankes Schema genügen.
Für einen belastbaren Graphen müssen unterschiedliche Bezeichnungen desselben Geräts zusammengeführt und Verknüpfungen auf Plausibilität geprüft werden. Eindeutige Kennungen und die Verbindung zur ursprünglichen Quelle helfen dabei. Eine gemeinsame Kundenkennung allein bedeutet beispielsweise noch nicht, dass zwei Tickets denselben Vorgang betreffen.
Vektorsuche: Ähnliche Problemstellungen und Lösungswege finden
Relevantes Wissen findet sich auch in Tickets, die zu anderen Kunden, Geräten oder Vorgängen gehören. Ein ähnliches Problem kann bereits an anderer Stelle aufgetreten und gelöst worden sein. Der Zusammenhang ergibt sich dann aus der beschriebenen Problemstellung, auch wenn keine direkte Verbindung über gemeinsame Entitäten besteht.
Um solche Fälle auffindbar zu machen, überführen wir die aufbereiteten Ticket-Inhalte mit einem Embedding-Modell in numerische Repräsentationen und indizieren sie in einer Vektordatenbank. Bei einer neuen Anfrage sucht das System nach inhaltlich ähnlichen Ticket-Passagen. So lassen sich verwandte Fehlerbeschreibungen und dokumentierte Lösungswege finden, selbst wenn Kunden unterschiedliche Formulierungen verwenden.
Zusätzliche Filter, etwa nach Produkt oder Version, helfen dabei, die Suche auf fachlich passende Fälle einzugrenzen. Ob eine frühere Lösung übertragbar ist, muss anhand der jeweiligen Bedingungen beurteilt werden.
Die beiden Ansätze liefern komplementäre Informationen: Der Knowledge Graph erschließt, was zum konkreten Kunden, Gerät oder Vorgang bereits bekannt ist. Die semantische Suche ergänzt Erfahrungen aus anderen Fällen mit ähnlicher Problemstellung. Im Beispiel liefert der Graph den Hinweis auf die bestehende Ersatzteilbestellung, während die Vektorsuche einen vergleichbaren Fehler und dessen dokumentierte Lösung bei einem anderen Kunden findet. Zusammen entsteht ein umfassenderer Kontext für den Antwortvorschlag, der sowohl den bisherigen Verlauf als auch mögliche Lösungswege berücksichtigt. Dieses gezielte Abrufen und Nutzen von Wissen folgt dem Prinzip Retrieval Augmented Generation, kurz RAG.
MCP-Tools: Wie der Agent auf das Wissen zugreift
Der Agent erhält die Suchfunktionen als Werkzeuge über das Model Context Protocol (MCP). Ein MCP-Server beschreibt, welche Tools verfügbar sind und welche Eingaben sie erwarten. In unserem Aufbau gehören dazu die exakte Ticketsuche, die semantische Ticketsuche und die Abfrage von Beziehungen im Knowledge Graph.
Der Agent wählt aus diesen freigegebenen Werkzeugen die für die Anfrage passenden aus und kann anhand eines Ergebnisses weitere Informationen anfordern. Die Suchfolge muss daher nicht für jede Anfrage gleich sein. Die Ergebnisse enthalten Verweise auf ihre Quellen; welche Daten zugänglich sind, bestimmen die eingerichteten Berechtigungen.
Über weitere MCP-Server lassen sich zusätzliche Quellen anbinden, etwa interne Wissensdatenbanken, Produktdokumentationen, E-Mail-Postfächer oder CRM-Systeme. Wir wählen sie passend zum Anwendungsfall aus. MCP vereinheitlicht den Werkzeugzugriff; passende Schnittstellen und Berechtigungen bleiben Voraussetzung. Das Zusammenspiel erläutert auch unsere Seite zu AI Agents.
Vom Ticket-Archiv zum gezielt abrufbaren Wissen
Warum ist es notwendig, die historischen Informationen aufzubereiten? Für jede neue Kundenanfrage den gesamten Bestand gelöster Tickets an ein Sprachmodell zu übergeben, ist ineffizient und teuer. Der Großteil der Inhalte ist für die konkrete Frage irrelevant. Mit wachsendem Archiv steigen die zu verarbeitende Textmenge, die Kosten und die Antwortzeit. Zudem passt der Bestand irgendwann nicht mehr in das Kontextfenster des Modells.
Deshalb bereiten wir die Tickets so auf, dass der Agent die benötigten Informationen gezielt abrufen kann. Dazu gehören die Bereinigung der Texte, die Extraktion von Entitäten und Beziehungen sowie die Indizierung für die Suche. Über passende Werkzeuge kann der Agent dann einen Vorgang nachschlagen, verknüpfte Informationen erschließen oder ähnliche Problemstellungen finden.
So wird aus dem Ticket-Archiv eine durchsuchbare Wissensbasis. Der Agent kann zunächst passende Fälle identifizieren und bei Bedarf einzelne Verläufe genauer abrufen. Das Sprachmodell erhält einen auf die Anfrage zugeschnittenen Kontext mit nachvollziehbaren Quellen.
Vom Support-Ticket zum Antwortvorschlag mit Human in the Loop
Die folgende Grafik zeigt, wie die von AltaSigma verwaltete Wissensbasis und der Ticket Agent mit den Quellsystemen und der Support-Oberfläche zusammenspielen.
Den recherchierten Kontext in eine Antwort übersetzen
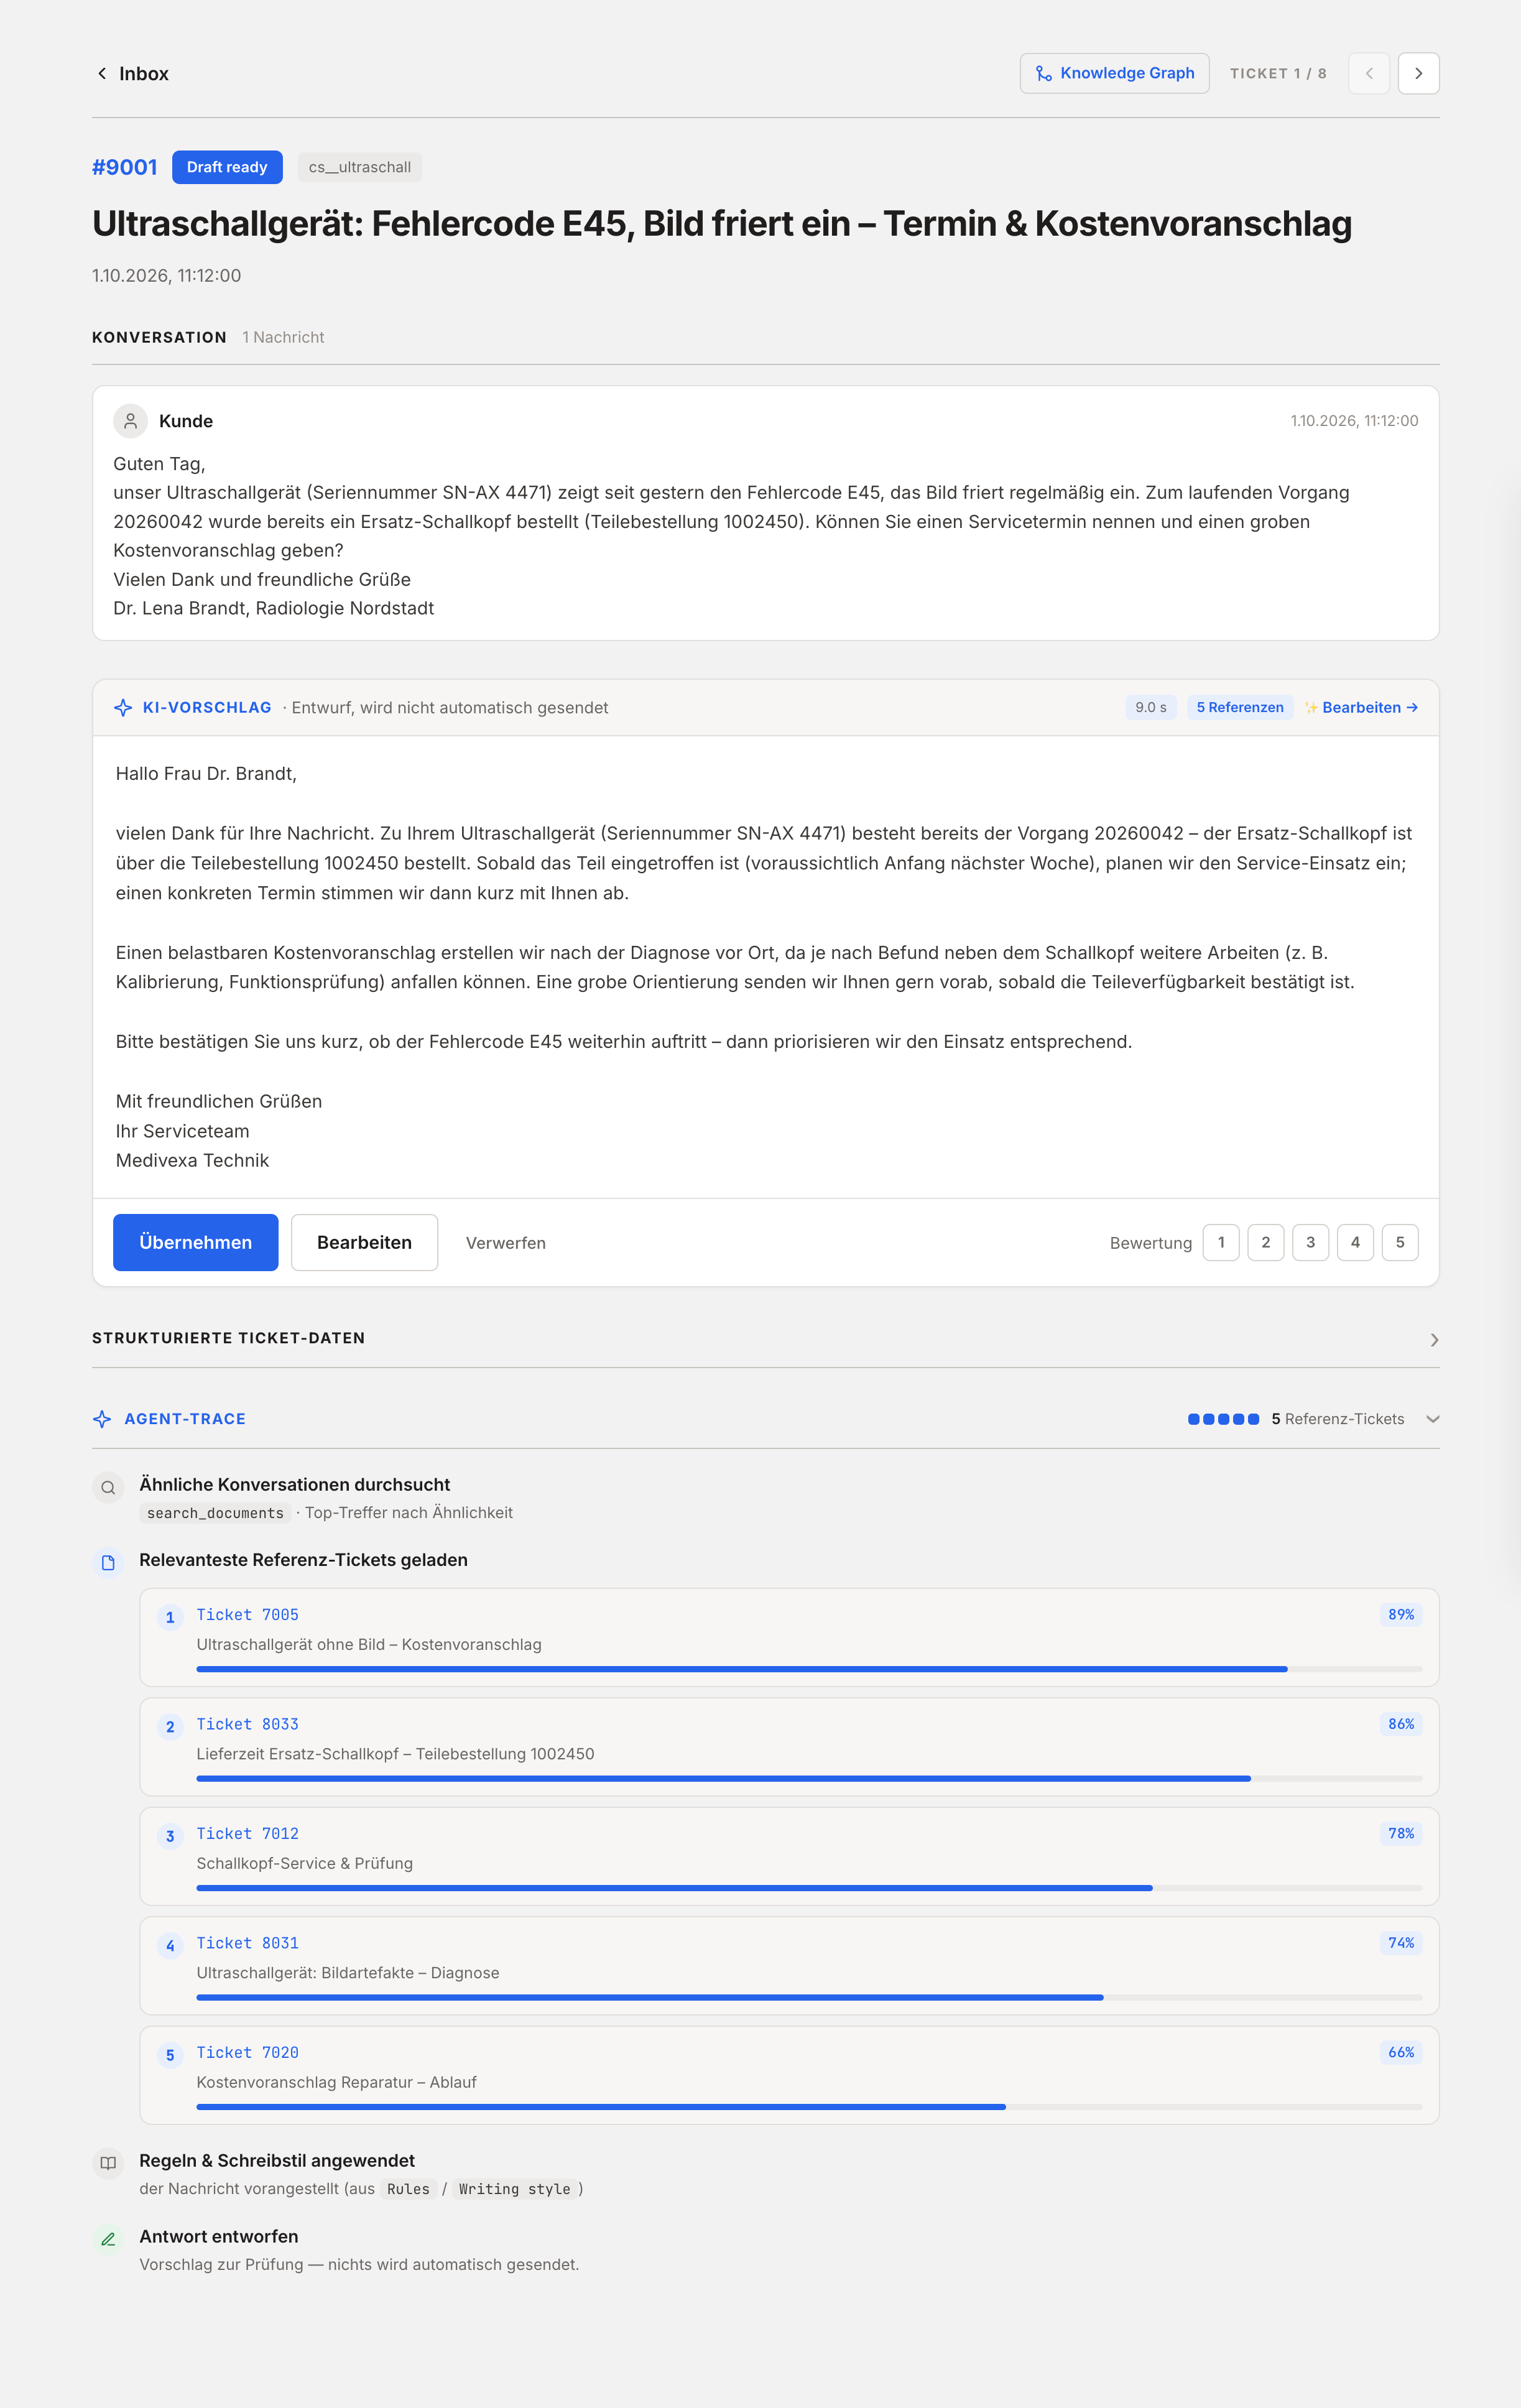
Für die Anfrage der Muster GmbH hat der Agent die frühere Bestellung gefunden. Ob das Ersatzteil inzwischen angekommen ist, bleibt im verfügbaren Wissen offen. Ein passender Entwurf greift deshalb den bestehenden Vorgang auf und fragt nach der fehlenden Information:
Das Beispiel zeigt eine wichtige Entscheidung: Wenn Informationen fehlen, kann eine gezielte Rückfrage die passende Antwort sein. In der internen Ansicht kann das Support-Team anhand der Referenz-Tickets prüfen, worauf der Entwurf beruht, und den aktuellen Bestellstatus gegebenenfalls im zuständigen System klären.
Die Entscheidung bleibt beim Support-Team
Mitarbeitende prüfen Inhalt und Quellen, ergänzen fehlende Angaben und passen die Formulierung an. Sie können den Entwurf übernehmen, überarbeiten oder verwerfen. Erst nach menschlicher Freigabe wird die Antwort versendet. Dieser feste Prüfschritt ist der Human in the Loop. Die dabei nötigen Korrekturen zeigen zugleich, wo Recherche oder Antworterstellung verbessert werden müssen.
Qualität und Betrieb im Model Management steuern
Ein funktionierender Beispieldialog reicht für die Einführung nicht aus. Für die Bewertung zählen typische Anfragen ebenso wie Fälle mit widersprüchlichen oder fehlenden Informationen. Entscheidend ist, ob der Agent den richtigen Vorgang findet, seine Aussagen durch Quellen gedeckt sind und welche fachlichen Korrekturen der Support vornehmen muss.
Im AltaSigma Model Management lassen sich dafür Referenzfälle und Referenzantworten hinterlegen. Änderungen am Agenten werden versioniert. Mit Augur Time Travel lassen sich frühere und aktuelle Einstellungen sowie Qualitätsmetriken vergleichen und vorherige Versionen wieder aktivieren. Bei solchen Vergleichen ist auch der Stand der angebundenen Quellen zu berücksichtigen. Rückblickende Tests dürfen die spätere Zielantwort nicht bereits als Rechercheergebnis enthalten.
Die passende Betriebsumgebung richtet sich nach den Anforderungen an Infrastruktur und Datenkontrolle. Mögliche Betriebsmodelle erläutern wir im Beitrag „Generative KI zur Analyse vertraulicher Unternehmensdaten“.
Mit einer Wissensquelle starten und gezielt erweitern
Für den Einstieg muss nicht das gesamte Unternehmenswissen erschlossen werden. Ein abgegrenzter Ticket-Bestand kann als erste Wissensquelle dienen. Die modulare Anbindung über MCP-Tools erlaubt es, weitere Quellen und Suchfunktionen schrittweise hinzuzunehmen, etwa Produktdokumentationen, interne Wissensartikel oder aktuelle Vorgangsdaten aus einem CRM-System.
Welche Erweiterung sinnvoll ist, lässt sich anhand konkreter Support-Anfragen bewerten. Wo fehlen Informationen? Welche zusätzliche Quelle hilft, diese Lücken zu schließen? Und verbessert sie tatsächlich die Antwortvorschläge? So wächst das System entlang des nachgewiesenen Bedarfs. Ein überschaubarer Einstieg ist möglich, ohne bereits alle späteren Quellen und Anwendungsfälle integrieren zu müssen.

LLM·14 Min. Lesezeit
Schneller, smarter, besser: LLMs als Gamechanger für Data Science
Artikel lesen
Uplift Modeling·6 Min. Lesezeit
Wie man mit Uplift Modeling die Wirkung von Marketingmaßnahmen testen kann
Artikel lesen
Explainable AI·5 Min. Lesezeit